
Asystent AI na danych firmy: jak wdrożyć, żeby dane nie wyciekły
Jak bezpiecznie wdrożyć asystenta AI na dokumentach firmy: trzy modele wdrożenia, miejsca wycieku danych i zasady projektowe, które je zamykają.
Asystent AI, który odpowiada na pytania na podstawie Twoich dokumentów, oszczędza czas. Ten sam asystent może pokazać pracownikowi plik, którego nie powinien widzieć. Ryzyko da się ograniczyć na etapie projektu, zanim ktokolwiek zada pierwsze pytanie. Poniżej opisujemy, jak to zrobić, i jak wygląda taki projekt u nas.
Co asystent AI robi z dokumentami firmy
Asystent AI na danych firmy to program, który czyta Twoje dokumenty i odpowiada na pytania pracowników w zwykłym języku. Pyta się go o umowę, procedurę, historię zlecenia albo ofertę sprzed roku. Zamiast przeszukiwać dysk, dostajesz odpowiedź ze wskazaniem źródła.
Technicznie działa to zwykle tak (technika nazywa się RAG, czyli retrieval-augmented generation). Dokumenty są wcześniej zindeksowane. Gdy ktoś zadaje pytanie, system wyszukuje pasujące fragmenty i dołącza je do pytania. Model językowy składa z nich odpowiedź.
Z punktu widzenia bezpieczeństwa liczy się jedno: fragmenty dokumentów opuszczają swoje miejsce i trafiają do modelu. Trzeba wiedzieć, dokąd, kto je widzi i czy system sprawdził wcześniej, kto pyta.
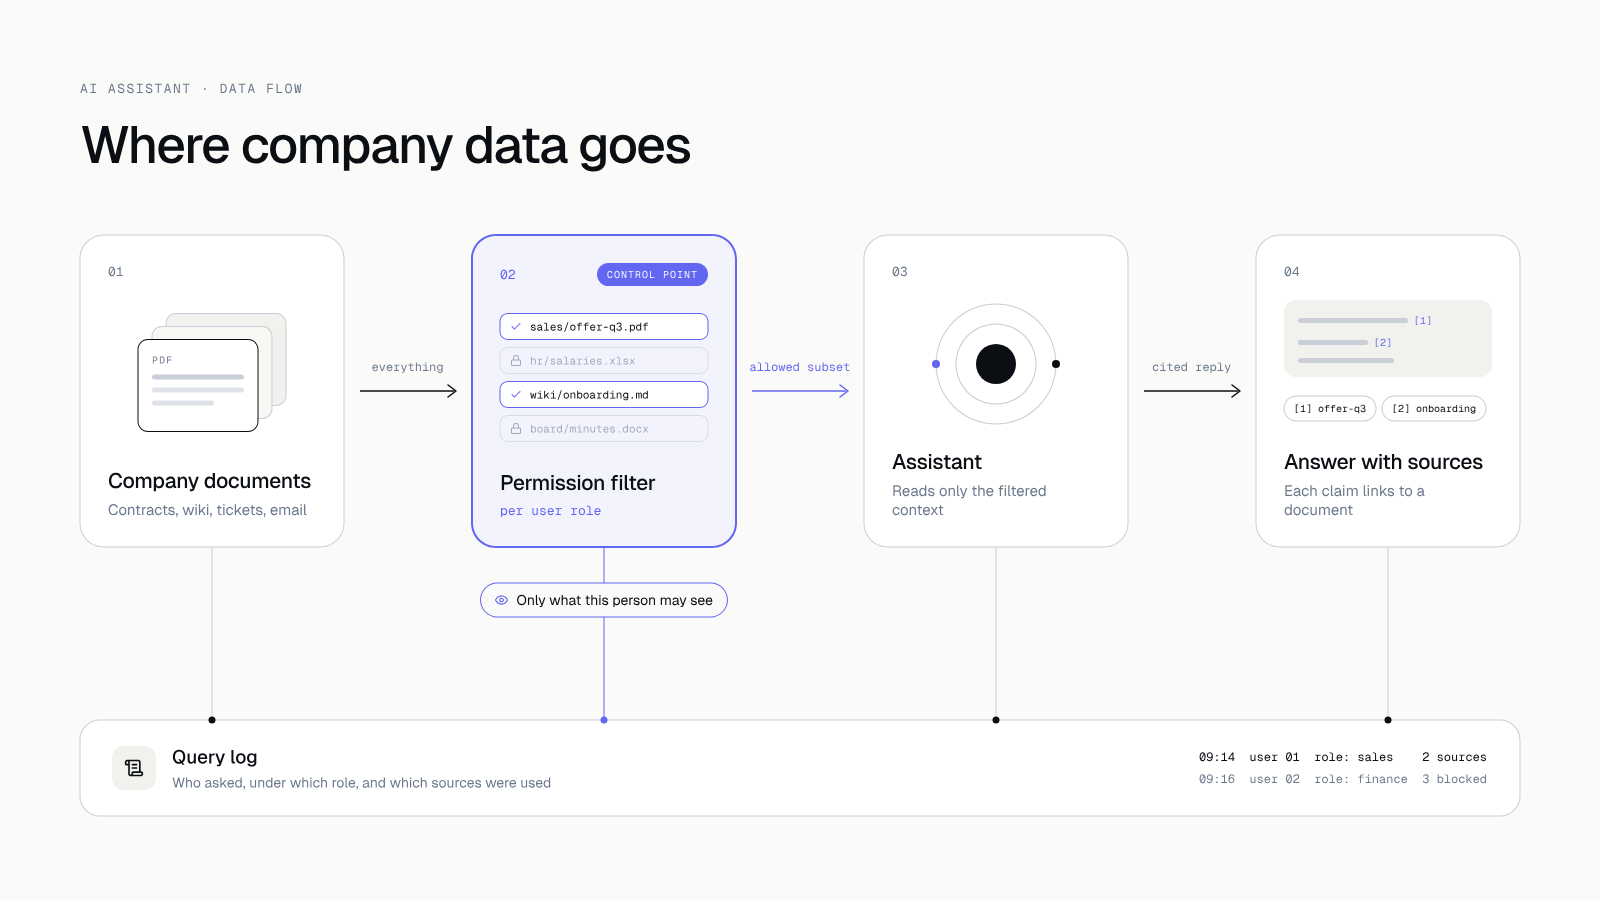 Filtr uprawnień stoi przed asystentem, a każde zapytanie trafia do dziennika.
Trzy modele wdrożenia
Wybór modelu decyduje o tym, gdzie fizycznie leżą dane i kto ma nad nimi kontrolę. Nie ma jednego dobrego rozwiązania, jest dopasowanie do rodzaju danych.
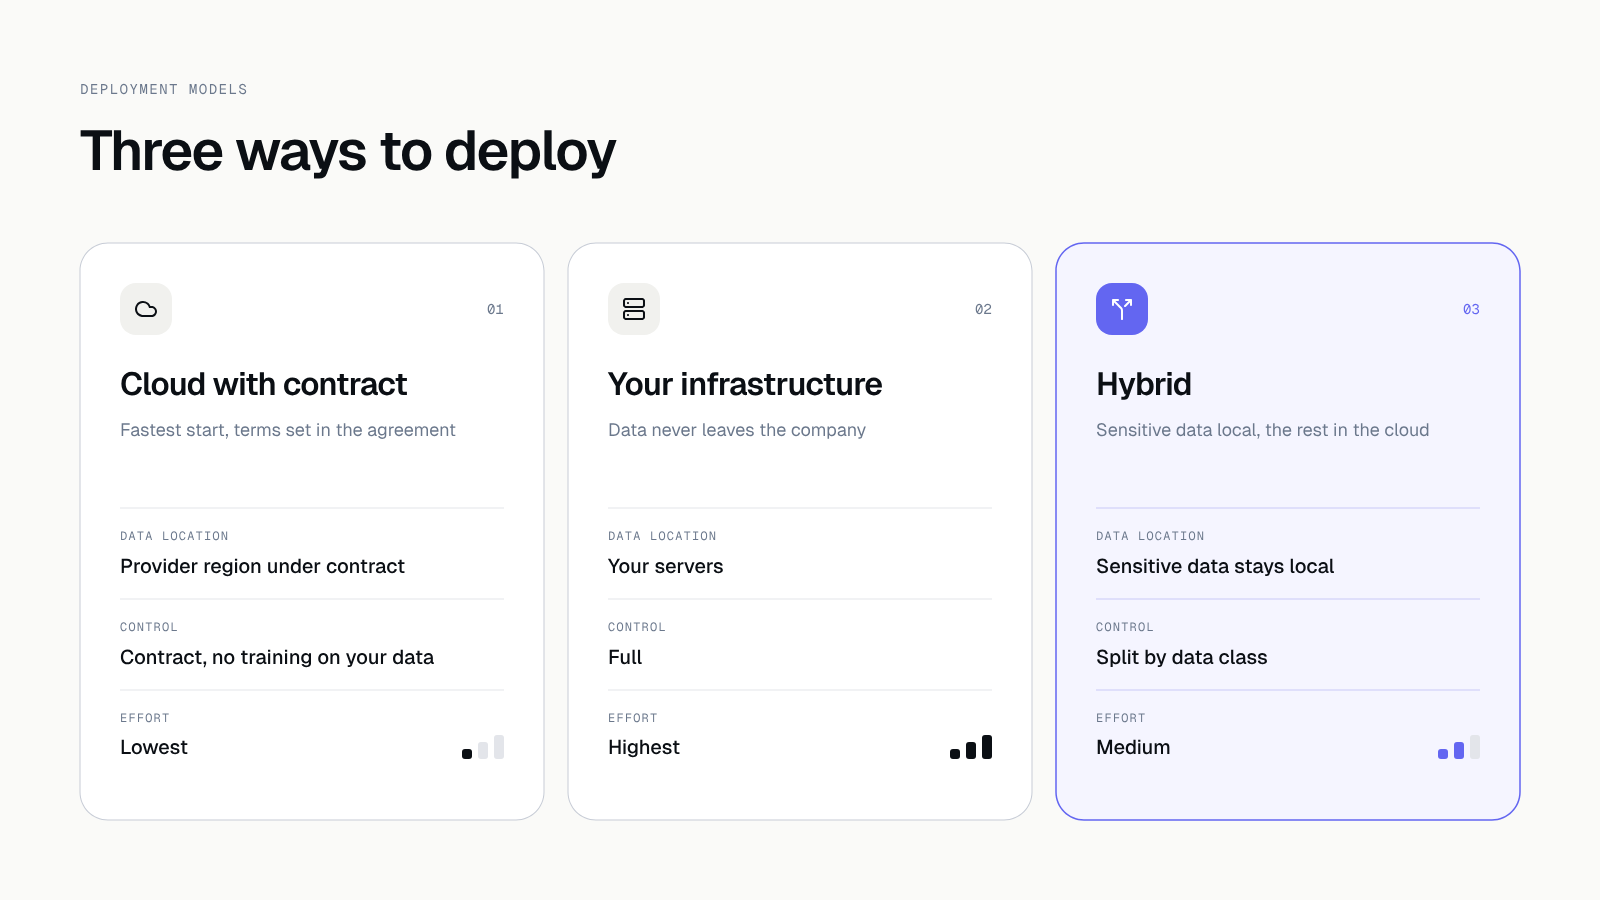 Trzy modele różnią się miejscem danych, kontrolą i nakładem pracy.
Model chmurowy z umową
Korzystasz z modelu językowego dostawcy przez interfejs API. Warunki wpisujesz do umowy: dane nie służą do uczenia modeli, region przetwarzania jest znany, a umowa powierzenia przetwarzania danych jest podpisana. To najszybsza i najtańsza droga. Sprawdza się przy dokumentach o średniej wrażliwości, takich jak procedury, oferty czy materiały szkoleniowe.
Model w infrastrukturze klienta
Model językowy działa na Twoich serwerach lub w Twojej prywatnej chmurze. Dane nie opuszczają firmy. Kontrola jest największa, ale rosną koszty infrastruktury i praca przy utrzymaniu. To rozsądny wybór dla dokumentów prawnych, medycznych i finansowych.
Połączenie obu
Dane dzielimy na klasy. Wrażliwe zostają u Ciebie, a mniej wrażliwe obsługuje model chmurowy. Wymaga to prostego, jasnego podziału: co jest czym i kto o tym decyduje. W praktyce często jest to najlepszy kompromis.
Gdzie wyciekają dane
Rzadko wyciek to efekt włamania do samego modelu. Najczęściej dane wypływają przez zwykłe, przyziemne miejsca.
| Miejsce | Co się dzieje | Co robimy |
|---|---|---|
| Prompty pracowników | Ktoś wkleja do okna czatu umowę klienta lub dane osobowe | Asystent działa w firmowym narzędziu, a zasady korzystania są spisane |
| Logi dostawcy | Zapytania i odpowiedzi zostają u dostawcy modelu | Umowa ogranicza retencję, a logi nie zawierają danych osobowych |
| Brak uprawnień per użytkownik | Asystent widzi wszystko, więc odpowiada każdemu na wszystko | Uprawnienia odzwierciedlają role w firmie |
| Integracje | Dostęp do poczty, dysku czy CRM-a nadany szerzej, niż potrzeba | Najmniejsze konieczne uprawnienia i osobne konto techniczne |
Drugi wiersz tabeli łatwo przeoczyć. Nawet jeśli model nie uczy się na Twoich danych, zapytania mogą być przechowywane w logach dostawcy. Sprawdź to w umowie, zanim wybierzesz rozwiązanie.
Zasady projektowe, które zamykają te luki
Pięć zasad stosujemy w każdym wdrożeniu AI.
- Uprawnienia odzwierciedlające role w firmie. Asystent odpowiada na podstawie tych dokumentów, do których zalogowany pracownik ma już dostęp. Handlowiec nie zobaczy umów o pracę, a księgowa ofert, których nie obsługuje. Filtr działa przed modelem, więc fragmenty bez dostępu w ogóle do niego nie trafiają.
- Minimalizacja danych. Do modelu wysyłamy tylko te fragmenty, które są potrzebne do odpowiedzi. Dane osobowe maskujemy tam, gdzie nie są potrzebne. Asystent dostaje wyłącznie zakres uzgodniony na warsztacie.
- Logowanie zapytań. Zapisujemy, kto, kiedy i o co pytał oraz z jakich źródeł system skorzystał. Dzięki temu da się wyjaśnić incydent i poprawić ustawienia. Same logi nie zawierają danych osobowych.
- Testy bezpieczeństwa przed startem. Sprawdzamy, czy da się obejść uprawnienia, wyciągnąć cudzy dokument sprytnym pytaniem lub wstrzyknąć polecenie przez treść dokumentu. Krytyczne i wysokie znaleziska naprawiamy przed startem.
- RODO i umowa powierzenia. Mapujemy, jakie dane osobowe trafiają do systemu, i podpisujemy umowy powierzenia z dostawcami hostingu i modelu. Wymaga to konsultacji prawnej po Twojej stronie. Podstawę prawną i okres przechowywania ustalasz razem ze swoim prawnikiem lub inspektorem ochrony danych.
Szerzej o pytaniach do wykonawcy piszemy w artykule Dane klientów w Twojej aplikacji: 15 pytań do wykonawcy.
Pytania do dostawcy, zanim podpiszesz umowę
Niezależnie od modelu wdrożenia zadaj dostawcy modelu i hostingu te same pytania. Odpowiedzi mają trafić do umowy.
- Czy dane z zapytań i dokumentów są używane do uczenia modeli? Odpowiedź ma być zapisana jako „nie”.
- W jakim regionie dane są przetwarzane i przechowywane?
- Jak długo dostawca trzyma logi zapytań i czy można to skrócić?
- Czy umowa powierzenia przetwarzania danych jest częścią oferty?
- Co się dzieje z danymi po zakończeniu współpracy i kto je usuwa?
- Kto z personelu dostawcy może zobaczyć Twoje zapytania?
Jeśli dostawca nie umie odpowiedzieć na któreś z nich, traktuj to jako sygnał ostrzegawczy. Dobrze sprawdza się tu ta sama logika, którą opisujemy w tekście Jak wybrać software house.
Czego asystent AI nie załatwi
Asystent nie naprawi bałaganu w dokumentach. Jeśli w firmie krążą trzy wersje tej samej procedury, usłyszysz odpowiedź opartą na którejś z nich. Przed wdrożeniem warto więc uporządkować źródła: wskazać aktualną wersję i właściciela każdego dokumentu.
Asystent nie zastąpi też decyzji człowieka tam, gdzie błąd kosztuje. Przy umowach, wycenach i sprawach prawnych odpowiedź ze źródłem ma być punktem wyjścia do sprawdzenia, a decyzję podejmuje człowiek. W prototypie pokazujemy źródło przy każdej odpowiedzi właśnie po to, żeby sprawdzenie zajmowało kilka sekund.
Jak wygląda taki projekt w Hindbrain
Pracujemy według tych samych sześciu etapów co przy każdym produkcie. Asystent AI ma w nich swoje stałe punkty kontrolne.
- Pomysł. Bezpłatna rozmowa, około godziny. Ustalamy, jakie pytania ma obsługiwać asystent i czy AI jest tu w ogóle potrzebne.
- Onboarding (warsztat discovery). Warsztat trwa 2 do 3 godzin i prowadzą go osoby, które znają dokumenty. Klasyfikujemy dane, ustalamy role i dobieramy model wdrożenia. Efektem jest zakres, harmonogram i stała wycena.
- Projektowanie (prototyp). Klikalny prototyp pokazuje, jak wygląda pytanie, odpowiedź ze źródłem i brak dostępu. Testujesz go z pracownikami.
- Produkt (sprinty). Budujemy w dwutygodniowych sprintach z demo na końcu. Środowisko testowe jest zawsze dostępne.
- Wdrożenie (audyt przed startem). Przed startem wykonujemy audyt bezpieczeństwa: uprawnienia, wycieki między rolami, zależności, kopie zapasowe. Raport dostajesz razem z produktem. Szczegóły opisujemy w artykule Audyt bezpieczeństwa aplikacji.
- Rozwój i utrzymanie. Monitoring, aktualizacje, łatanie podatności i miesięczny raport.
Kod, projekty i konta należą do Ciebie od pierwszego dnia, a po każdym etapie decydujesz, czy idziemy dalej. Oznacza to, że dane i konfiguracja asystenta też zostają po Twojej stronie.
Co zrobić dziś
Wypisz pięć pytań, na które Twój zespół odpowiada najczęściej, i przy każdym zapisz, w jakich dokumentach leży odpowiedź. Przy każdym dokumencie dopisz jedno słowo: publiczny, wewnętrzny albo poufny. Ta lista to połowa materiału na warsztat discovery.
Porozmawiajmy o asystencie na Twoich danych
Jeśli myślisz o AI na dokumentach firmy i chcesz wiedzieć, który model wdrożenia pasuje do Twoich danych, umów się na warsztat discovery. Zaczniemy od bezpłatnej rozmowy, bez zobowiązań. Umów rozmowę.